Strata Qwen 详解:在 12 GB 显卡上运行 1250 亿参数的 Qwen3.8-Flash-Next
"Strata Qwen" 是什么?开源引擎 Strata 如何在游戏电脑上跑 125B 的 Qwen3.8-Flash-Next:实测速度、硬件要求、安装步骤与局限一次讲清。
 viddir 团队
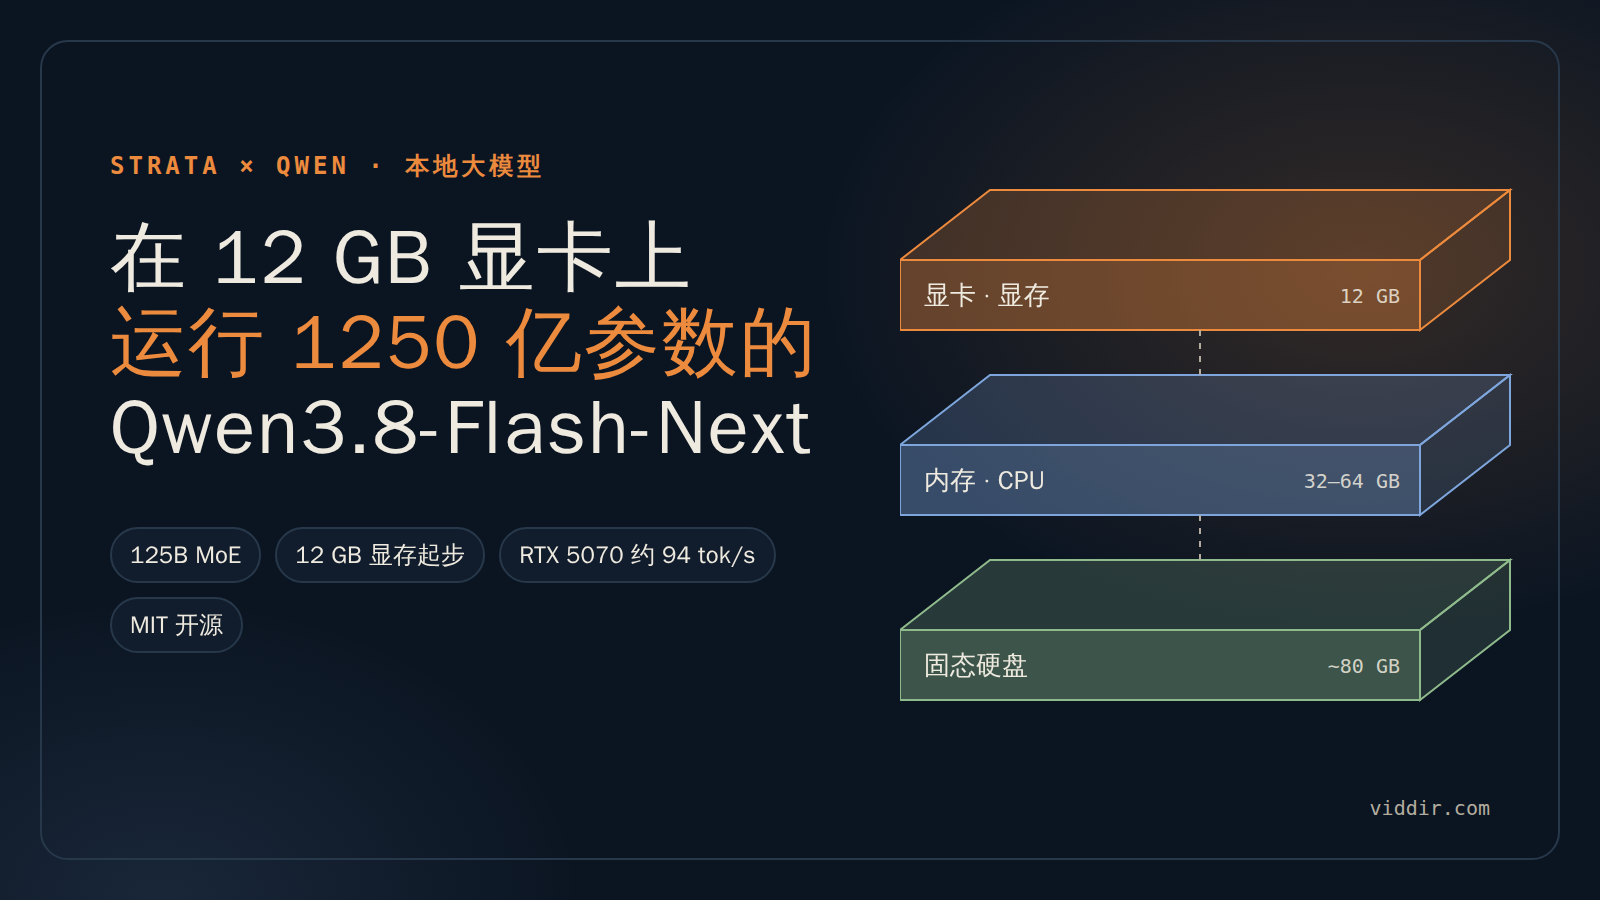
大家搜索 "Strata Qwen" 时,几乎都指同一件事:Strata,一款免费开源的应用,能在配 12 GB 显卡的普通游戏电脑上运行阿里通义千问的 Qwen3.8-Flash-Next,一个 1250 亿参数的混合专家(MoE)模型。不用云端,不付 API 费用,装好后本机就有一个兼容 OpenAI 的接口。
本文汇总了项目文档、早期用户实测和媒体报道,帮你判断 Strata Qwen 值不值得在自己电脑上下载这 80 GB。
30 秒看懂 Strata Qwen
- **它是什么:**专为一个模型打造的推理引擎,只跑 Qwen3.8-Flash-Next(125B MoE)。它不是 Ollama、LM Studio 那样的通用模型运行器。
- **最低配置:**12 GB 显存的 NVIDIA RTX 20/30/40/50 或 AMD Radeon RX 7800/7900/9060/9070 显卡,32 GB 内存(推荐 64 GB),约 80 GB 固态硬盘空间。
- **速度:**RTX 5070 上用最快的模型包约 94 tokens/s,更强的显卡上用户实测 75 到 130 tokens/s。
- **安装:**Windows 双击
START-HERE.bat,Linux 运行./setup.sh,装好后浏览器打开http://127.0.0.1:8080即可聊天。 - **许可证:**MIT。写作时最新版本为 v0.1.38(2026 年 10 月 3 日发布)。
Strata 是什么?
Strata 是开发者 Niko1221 在 GitHub 上开源的专用推理引擎加一键安装器,口号很直接:让 Qwen3.8-Flash-Next 跑在任何消费级硬件上。安装器会识别你的显卡、推荐合适的模型包并自动下载,然后在 8080 端口提供三样东西:
- 一个网页聊天界面,可选支持图片输入。
- 兼容 OpenAI 的 API:
http://127.0.0.1:8080/v1。 - 兼容 Anthropic 的 API:
http://127.0.0.1:8080/v1/messages,编程 Agent 和 MCP 客户端可以直接接入。
它还支持思考模式(关、低、中、高)、以 8,192 token 为一批的长上下文处理、多显卡,以及投机解码。官方称投机解码能让回复快约 1.6 到 1.8 倍,且不改变输出结果。
想看精简版介绍,可以访问我们的 Strata 产品页。
Qwen3.8-Flash-Next 是什么?
Qwen3.8-Flash-Next 是阿里通义千问(Qwen)系列的开放权重模型,参数量 1250 亿,但它是**混合专家(MoE)**架构:48 层里一共有 24,576 个路由专家,而每个 token 只会激活其中极少一部分。正是这种稀疏性,让这么大的模型能在游戏电脑上跑起来:你不需要把 125B 参数全部放进高速显存,只需要当前 token 用到的那几个专家。
Strata 怎么把 125B 模型塞进 12 GB 显卡
Strata 把你的电脑当成三层存储,每生成一个 token,三层同时工作:
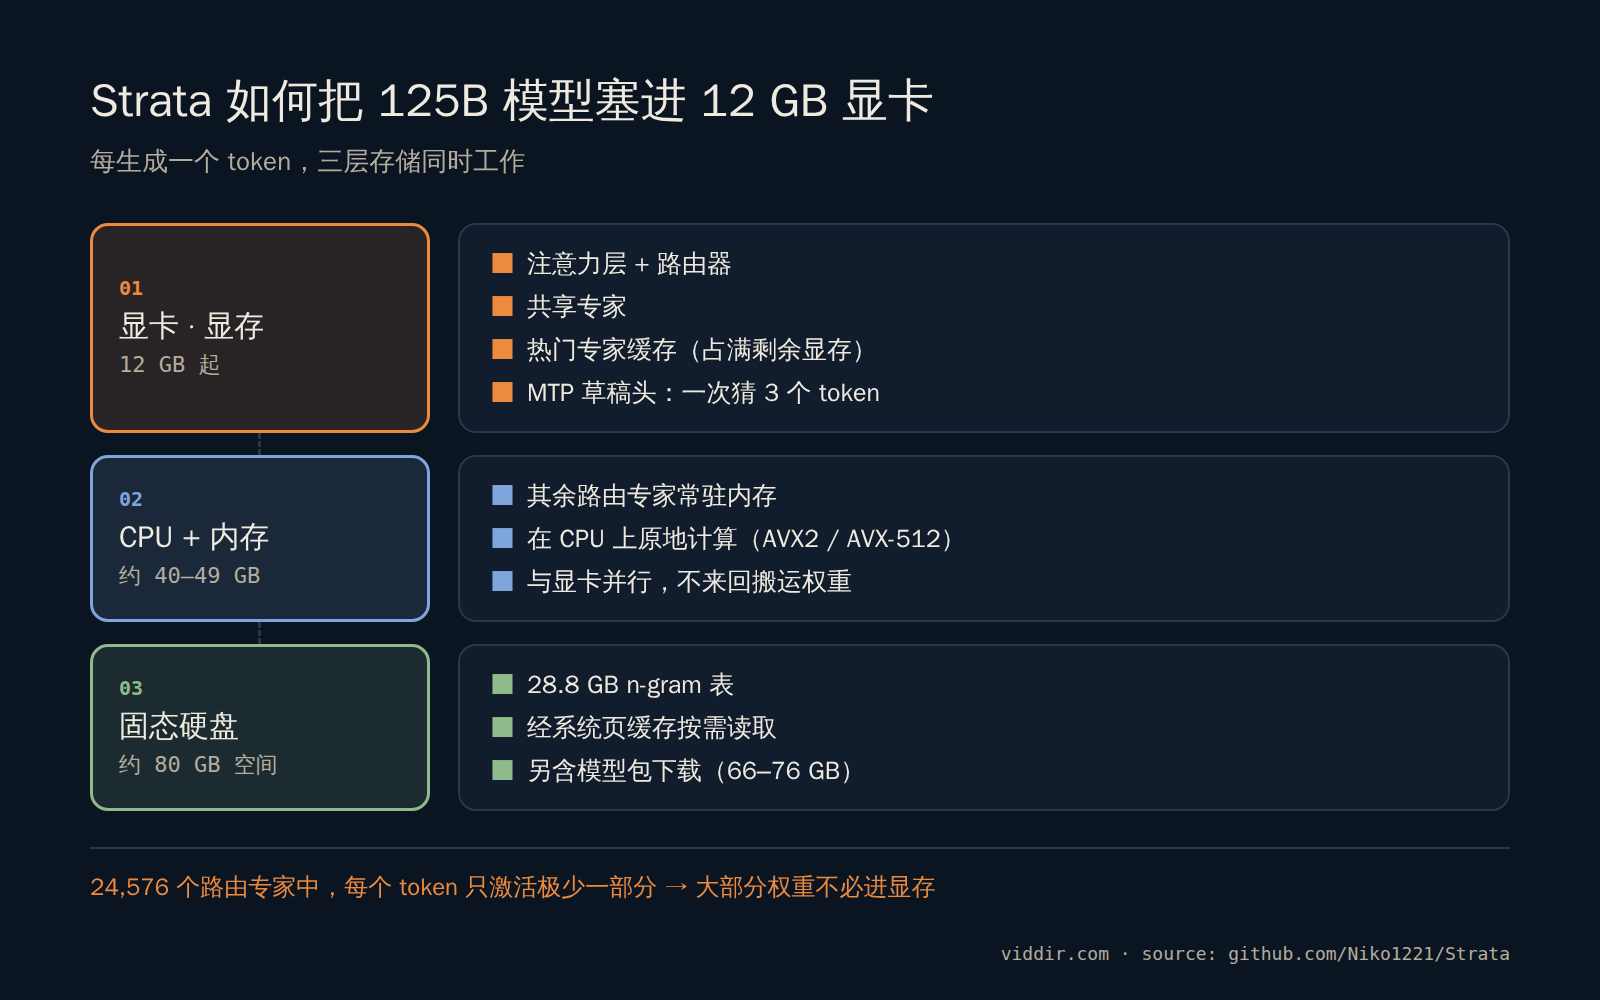
- **显卡(显存):**放注意力层、路由器和共享专家,剩余显存全部用作缓存,存放最常被调用的专家。
- CPU + 内存:其余路由专家常驻系统内存,由 CPU 用 AVX2 或 AVX-512 指令原地计算,与显卡处理缓存专家同时进行。权重不会每个 token 都通过 PCIe 来回搬运。
- **固态硬盘:**一张 28.8 GB 的 n-gram 表,通过操作系统页缓存按需读取。
此外,模型自带的多 token 预测(MTP)层每次最多先"猜" 3 个 token,再用一次完整的 48 层前向计算来验证。平均每次能确认 2.4 到 3.2 个 token,这就是"先猜后验"提速的来源。
实际结论是:**内存不是溢出备用区,而是引擎的一部分。**所以内存大小和显卡一样重要。
硬件要求
| 部件 | 最低 | 推荐 |
|---|---|---|
| 显卡 | 12 GB 显存:NVIDIA RTX 20/30/40/50 或 AMD RX 7800/7900/9060/9070 | 显存越大,专家缓存越大 |
| 内存 | 32 GB(仅 Coder 包) | 64 GB,所有模型包都能装下 |
| CPU | 支持 AVX2 的 x86-64 | AVX-512(如锐龙 7000/9000)略快 |
| 硬盘 | 约 80 GB 空闲 | NVMe 固态 |
| 系统 | Windows 10/11 或 Linux,驱动保持最新 |
最近几个版本也改进了小显存显卡的支持,v0.1.38 的更新说明提到最低可到 6 GB,但低于 12 GB 时速度会明显下降。
Strata Qwen 有多快?
项目官方在 **RTX 5070(12 GB)**上的测试,上下文 4K、生成 256 个 token:
| 模型包 | 提示词处理 | 生成速度 |
|---|---|---|
| Q2_0 | 539 tok/s | 94.6 tok/s |
| IQ2_XS | 463 tok/s | 78.0 tok/s |
| IQ3_XXS | 410 tok/s | 65.6 tok/s |
上下文越长速度越慢:在 262K 上下文下,Q2_0 仍有约 56 tokens/s。目前看到的其他数据:
- **RX 9070 XT(16 GB):**README 给出 Q2_0 约 60 tok/s,Coder 包约 44 tok/s。
- Radeon RX 7900 XTX:LinuxCompatible 对 v0.1.38 的报道称简单提示词最高约 120 tok/s,混合场景稳定在 75 tok/s 左右。
- RTX 5090(PCIe x4 连接)+ 128 GB 内存:note.com 上一篇两天实测记录中,代码生成达到 114 到 133 tok/s,占用约 31 GB 显存和 56 GB 内存。
对于本地运行的 125B 模型来说,这些数字相当惊人。以往在消费级硬件上跑这个量级的模型,大多只有个位数的速度。
该选哪个模型包?
| 模型包 | 下载大小 | 内存占用 | 取舍 |
|---|---|---|---|
| Q2_0 | 66 GB | 约 40 GB | 最快,质量不错 |
| IQ2_XS | 68 GB | 约 42 GB | 速度接近 Q2_0,质量更好 |
| IQ3_XXS | 76 GB | 约 49 GB | 质量最好,较慢(CPU 计算更多) |
| Coder | - | 32 GB 可用 | 针对代码优化,约为完整模型的 91% |
三个通用模型包都能装进 64 GB 内存;48 GB 内存只能用 Q2_0 和 IQ2_XS。只有 32 GB 内存的话,选 Coder 包。另外还有一个"Swift 1.5"微调版,主打更短的推理链。
**关于质量:**这些是 2 位和 3 位量化,和官方全精度模型确实有差距,Strata 团队也公开承认这一点。不过实际差距比想象中小:note.com 的测试者在 60 道编程题上得分 90.0%,把推理上限从 16,384 提到 32,768 token 后升到 96.7%。如果难题上出现空回答,先给模型更多思考预算,再怀疑量化。
如何安装 Strata Qwen
- 下载或克隆 github.com/Niko1221/Strata。
- **Windows:**双击
START-HERE.bat。**Linux:**在 Strata 文件夹里运行./setup.sh。 - 接受推荐的模型包(下载约 70 GB)。
- 等待模型加载进内存。首次加载时电脑可能卡住 1 到 3 分钟,属于正常现象。
- 浏览器自动打开
http://127.0.0.1:8080,开始聊天。
之后更新时,请重新运行 setup.sh(或 Windows 启动脚本)。只执行 git pull 不会重新构建引擎,很容易错过性能更新。如果 8080 端口被其他服务占用,修改 Strata 的端口即可。
把 Strata Qwen 当作本地 API 使用
任何支持 OpenAI API 的工具,只要把 base URL 改掉就能用 Strata:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-flash-next",
    "messages": [{"role": "user", "content": "用两句话解释混合专家模型。"}]
  }'
需要 Anthropic Messages API 的编程 Agent 可以改连 http://127.0.0.1:8080/v1/messages,Strata 也能作为 MCP 服务器接入 AI 编程助手。具体暴露的模型名称请以 README 和你本机安装为准。
下载前要知道的局限
- **只能跑一个模型。**Strata 快,正是因为它专一。它不能运行 Llama、DeepSeek 或其他尺寸的 Qwen。
- **一次只处理一个请求。**它是个人引擎,不是多用户服务器。
- **贪心解码。**temperature 参数会被忽略。
- **暂无对话缓存。**每个请求都会重新处理完整提示词,所以长对话的首 token 延迟会更长。
- 图片输入目前只支持 Linux 下的 AMD 显卡。
其他同名的 "Strata Qwen"
如果你是从搜索结果进来的,还有两个无关的项目也叫这个名字:
- **Strata(arXiv 2508.18572)**是一篇关于长上下文大模型服务中分层上下文缓存的研究论文,讲的是数据中心推理,与在家跑 Qwen 无关。
- Hugging Face 上的 strata-qwen2.5-1.5b 检查点是为 ALFWorld 等 Agent 基准训练的小型研究模型,与 Strata 应用无关。
常见问题
Strata Qwen 免费吗?
免费。Strata 采用 MIT 许可证,模型包也可免费下载,你只需要承担硬件和电费。
笔记本能跑吗?
只要笔记本有 12 GB 的 NVIDIA 或受支持的 AMD 显卡,并且至少 32 GB 内存,就可以。大多数轻薄本达不到内存要求。
能离线使用吗?
完成一次性下载后可以。一切都运行在 127.0.0.1 上。
Strata 和 Ollama、LM Studio 有什么区别?
Ollama 和 LM Studio 用一个通用运行时跑很多模型;Strata 只跑一个模型,运行时专门针对它的架构调优,所以才能让 125B 模型在 12 GB 显卡上跑到这个速度。两者可以并用:小模型用通用运行器,想用 Qwen3.8-Flash-Next 时用 Strata。
总结
Strata Qwen 是目前在游戏电脑上运行前沿规模开源模型最实用的方案。如果你有 12 GB 显卡和 64 GB 内存,值得一试。建议从 IQ2_XS 包开始,它在速度和质量之间最平衡;给足推理预算,再把你的编程工具接到本地 API 上。
在我们的 Strata 产品页查看更多信息,或浏览完整的 AI 工具导航。
参考来源:Strata README、Strata 技术细节、LinuxCompatible 对 v0.1.38 的报道、zephel01 的实测记录。